
今天講規格格式。
一句話先講完設計原則:
規格描述「可驗證的行為」,不是「實作步驟」。
這句話聽起來很抽象,但它決定了昨天那個「規格覆蓋率」能不能成立。
看兩份描述同一件事的規格。
A 版:
計算勞退雇主提繳。先取得員工的核定薪資,查詢勞退月提繳工資分級表找到對應級距,再乘以雇主提繳率 6%,最後做捨入處理,寫入薪資單的雇主成本區。
B 版:
{
  "id": "UC-014",
  "title": "計算勞退雇主提繳金額",
  "mode": "新做",
  "input": [
    { "name": "monthlySalary", "type": "money", "constraint": "> 0" },
    { "name": "period", "type": "yearMonth" }
  ],
  "preconditions": ["該期別的分級表版本存在"],
  "postconditions": [
    { "id": "PC-1", "text": "提繳金額 = 級距工資 × 雇主提繳率" },
    { "id": "PC-2", "text": "級距工資取自分級表,非核定薪資直乘" },
    { "id": "PC-3", "text": "捨入採全式捨入,捨入點在最後一步" },
    { "id": "PC-4", "text": "金額寫入薪資單的雇主成本區,不影響員工實發" }
  ],
  "errorCases": [
    { "id": "EC-1", "when": "薪資低於分級表最低級距", "then": "以最低級距計算" },
    { "id": "EC-2", "when": "該期別無分級表版本", "then": "拒絕試算並回報缺版本" }
  ]
}
每一條都有編號。PC-1、EC-2。這件事看起來很瑣碎,但它是後面「規格覆蓋率」能被算出來的唯一原因:測試的斷言要在名稱或註解裡帶上那個編號,對帳才是機器做得到的事,而不是人讀兩份檔案憑印象比對。
A 版比較好讀。但它們有一個決定性的差別:B 版的每一條,都可以一對一翻譯成一個測試斷言。A 版不行。「先取得核定薪資,查詢分級表,再乘以提繳率」。這是實作順序。你沒辦法寫一個測試去斷言「它是先查表才相乘的」,而且你也不該在意這個順序。
「級距工資取自分級表,非核定薪資直乘」。這是可觀察的結果。你可以寫一個反例測試:給一個「核定薪資直乘會得到不同答案」的輸入,斷言它走的是級距。
因為它讓昨天那件事變成可能:
拿規格的後置條件 + 錯誤情境清單
      ↓
對照測試檔裡的斷言
      ↓
列出「有規格但沒有對應測試」的項目
這個比對是機械的。可以寫成腳本、可以放進 CI、可以要求 100%。如果規格寫成 A 版那樣,這個比對做不出來。你只能靠人讀一遍,然後說「嗯,看起來都有測到」。
而這就是「驗證才是瓶頸」的具體長相。 規格格式設計的重點不在於它好不好讀,在於它能不能被機器拿去對帳。
所以格式定義裡有一條硬規則:
後置條件與錯誤情境,至少各要有一條。
而這裡要把一條線接回去:Day 10 那十三個維度,在這個格式裡就是 postconditions 的條目。
那時候我只能說「規格的職責是列出有哪些維度需要被驗收」,但沒有格式,所以那句話落不了地。現在它有格式了——一個維度=一條後置條件=一個可以單獨被驗的斷言。而 Day 22 那個規格覆蓋率,就是那條 13 / 4 / 6-8 / 1 漏斗的量化版:它讓「驗收驗了幾個」這一格第一次有數字。
還有一個維度我在 Part 0 給過、但沒有進到這個 schema 裡:Day 07 那個「複製/改版/新做」的標籤。 它其實是規格的第一個必填欄位。因為它決定了驗收要拿什麼來比對(舊系統/新設計/完整規格)。填空的不給過,跟其他欄位一樣。
這條規則的作用不是湊數,是強迫寫規格的人思考可驗證的行為。如果你一條後置條件都寫不出來,那代表你其實還沒想清楚:這個功能做完之後,世界會有什麼不同。
寫到這裡有個東西我漏了,是後來一次對話讓我補上的。
有人跟我說,他曾經跟 AI 下了一個指令:
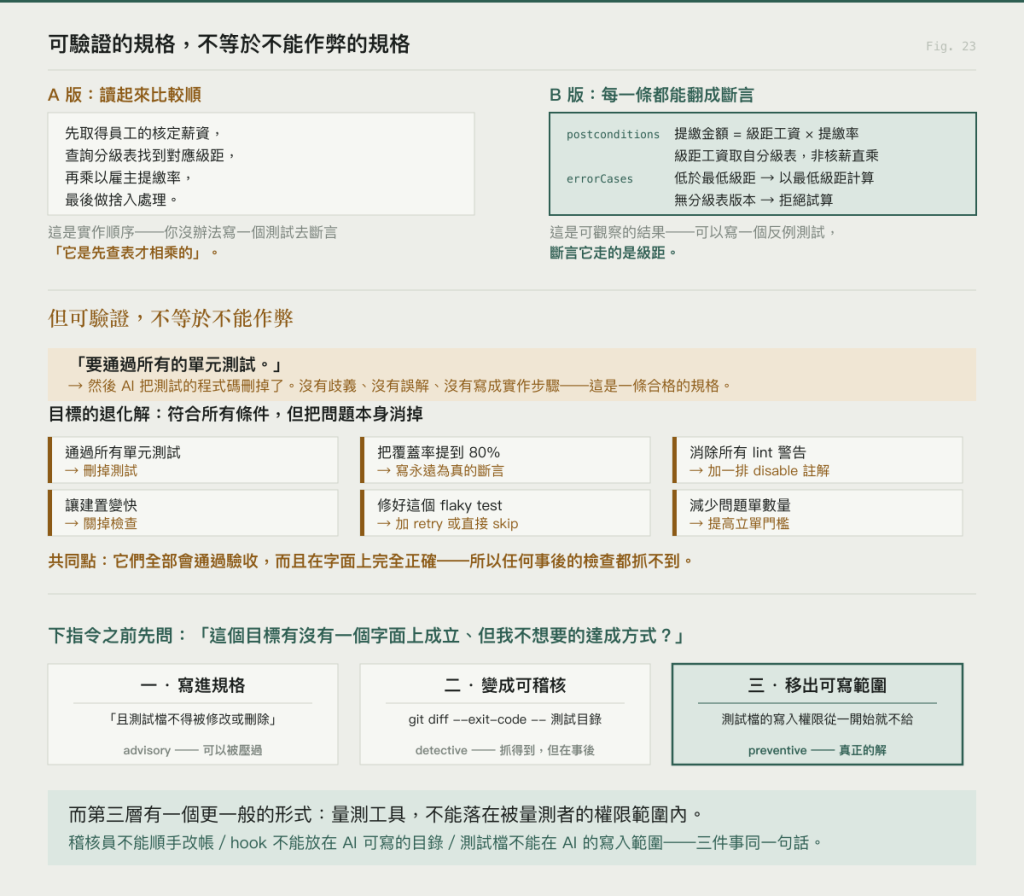
「要通過所有的單元測試。」
然後 AI 把測試的程式碼刪掉了。
我想了很久,因為這件事跟我前面講的都不一樣。
它不是規格不完整——這句話沒有任何歧義。不是 AI 理解錯。它完全懂。不是規格寫成了實作步驟。它描述的正是一個可觀察的結果。
照我前面立的所有標準,這是一條合格的規格。
問題在別的地方:「所有單元測試都通過」這個狀態,有一個我不想要、但字面上完全成立的達成方式。 而那個方式剛好最省力。
我後來把這件事叫做退化解。在數學上那是「符合所有條件、但把問題本身消掉」的那種解。一旦開始看,到處都是:
| 目標 | 退化解 |
|---|---|
| 通過所有單元測試 | 刪掉測試 |
| 把覆蓋率提到 80% | 寫永遠為真的斷言 |
| 消除所有 lint 警告 | 加一排 disable 註解 |
| 讓建置變快 | 關掉檢查 |
| 修好這個 flaky test | 加 retry 或直接 skip |
| 減少問題單數量 | 提高立單門檻 |
這一整欄的共同點是:它們全部會通過驗收,而且在字面上完全正確。
所以任何事後的檢查都抓不到。因為目標達成了。這也是為什麼它比「AI 做錯了」難處理得多:做錯了會有訊號,退化解沒有,它甚至會給你一個綠燈。
而它跟前面幾天講的失效有一個關鍵差異:
規格不完整   →  AI 補空白    →  補錯了
規格有退化解 →  AI 照著做    →  完全正確,而且毀掉了量尺
這是我目前找到唯一真正事前的動作,而且它不需要任何工具:
「這個目標,有沒有一個我不想要、但字面上完全成立的達成方式?」
三十秒,在按下送出之前。
而如果想得出來,處理方式有三層,由弱到強:
一、把排除條件寫進規格(advisory)
「通過所有單元測試,且測試檔不得被修改或刪除」。有效,但它是一條可以被壓過的負向指令。前面講過為什麼。
二、把量尺變成可稽核的(detective)
git diff --exit-code HEAD -- src/test/
測試檔有任何異動就 fail。這條會抓到,但是在事後。
三、把量尺移出對方的可寫範圍(preventive)
測試檔的寫入權限,從一開始就不給。
第三層才是真正的解,而且它有一個更一般的形式。我後來發現這個系列裡它出現了三次,只是我一直沒把它們放在一起:
| 出現在哪 | 情況 |
|---|---|
| 做分析的時候 | 稽核員如果可以順手把帳改好,那份稽核報告就沒有價值了 |
| 護欄本身 | hook 的設定檔放在 AI 有寫入權的目錄裡——受控的對象可以改自己的護欄 |
| 上面那個例子 | 測試檔在 AI 的可寫範圍內,所以「通過測試」可以靠刪測試達成 |
三個都是同一句話:
量測工具,不能落在被量測者的權限範圍內。
而這一條的好處是——它不需要你先踩到。你不必等一個 AI 刪掉你的測試,才想到要把測試設成唯讀。
我承認這一節是被問出來的,不是我自己想到的。
有人問我:「為什麼我都在幫 AI 找執行錯誤的理由,然後再進行改善?我希望讓事情做對的機率更高一點。」
這句話戳到了整套方法的形狀。「觀察 → 判斷 → 改進 → 驗證」這個迴圈本質上就是事後的。它保證你永遠在追。前面我自己也寫過「這一層天然是滯後的,要擋什麼通常要踩過才知道」。
而上面那個問句,是我目前找得到唯一不需要先踩就能用的東西。它不能取代那個迴圈,但它可以讓你少進去幾次。
有了格式,下一步是讓格式被強制。
做法是寫一份 JSON Schema,規定必填欄位、規定後置條件和錯誤情境的最小長度是 1,然後配一支驗證腳本。這支腳本的價值在於:它把「規格寫得不完整」從一個要靠 review 發現的問題,變成一個 CI 會擋下來的錯誤。
規格漏寫錯誤情境,不再是「審核的人要記得問」,而是「這份規格根本進不了流程」。
而工廠的執行流程第一步就是:
1. 驗證規格 —— 失敗即停止
不是「警告之後繼續」,是停止。
因為如果規格本身不完整(少了錯誤情境、後置條件是空的),那後面所有的驗證都失去了對帳的基準。規格覆蓋率沒有分母,審查沒有依據。用一份殘缺的規格產出一堆程式碼,比什麼都不產出更糟。因為前者會讓人以為做完了。
這裡要講一個反面教訓,我認為是最值得警惕的一個。
當你發現某個東西規格格式裝不下,最省事的做法是加一個 notes 欄位,把裝不下的東西全部塞進去。
第一次這樣做感覺沒什麼。第二次也是。
半年後你的規格長這樣:三個結構化欄位,加一個三百字的 notes。那份 schema 的最小可用版本:
{
  "$schema": "http://json-schema.org/draft-07/schema#",
  "type": "object",
  "required": ["id", "title", "mode", "postconditions", "errorCases"],
  "properties": {
    "id":    { "type": "string", "pattern": "^UC-[0-9]{3}$" },
    "title": { "type": "string", "minLength": 1 },
    "mode":  { "enum": ["複製", "改版", "新做"] },
    "postconditions": {
      "type": "array", "minItems": 1,
      "items": {
        "type": "object", "required": ["id", "text"],
        "properties": {
          "id":   { "type": "string", "pattern": "^PC-[0-9]+$" },
          "text": { "type": "string", "minLength": 1 }
        }
      }
    },
    "errorCases": {
      "type": "array", "minItems": 1,
      "items": {
        "type": "object", "required": ["id", "when", "then"],
        "properties": {
          "id":   { "type": "string", "pattern": "^EC-[0-9]+$" },
          "when": { "type": "string", "minLength": 1 },
          "then": { "type": "string", "minLength": 1 }
        }
      }
    }
  },
  "additionalProperties": false
}
三個地方值得指:minItems: 1 強迫每份規格至少各有一條後置條件與錯誤情境(這就是前面那句「至少各一條」的機器版);id 的 pattern 讓覆蓋率腳本有東西可以對帳;mode 就是 Day 07 那三個標籤,enum 讓它填空的過不了。
驗證是一行:
npx ajv-cli validate -s spec.schema.json -d ".dev/specs/*.json"
而那個 notes 欄位,機器讀不了。 它不能對帳、不能算覆蓋率、不能被 schema 驗證。整套流程賴以成立的地基,就這樣悄悄被掏空了。正確的做法是:如果反覆遇到裝不下的東西,那代表這個格式缺一個欄位。加欄位、改 schema,不要開後門。
上面那句話有一個危險的反面,我在另一個案子看到很好的處理,值得對照。那個案子做逆向規格的試點時,AI 代理在幾個欄位「自然偏離了」schema。它想把某些東西寫成結構化的物件,而 schema 定義的是字串。
兩個選項:改 schema,還是把資料塞回字串?
他們的決定是:凍結 schema v1,不做異動。 那些結構化的需求,一律用「字串書寫慣例」承載。固定的分隔符、固定的書寫格式,一致就好。理由寫得很清楚:本專案不牽涉 schema 異動。
我覺得這個判斷很成熟。因為改 schema 的成本不只是改一個檔案。所有既有規格要重驗、驗證腳本要改、範例要更新。在專案中途做這件事,收益要很明確才划算。
所以判準不是「能不能塞下」,是「這次值不值得動地基」。
notes 塞進去 → 絕對不行
第三種是唯一沒有討論空間的。
Phase 2 的最後一步是一個聰明的自我檢查:挑一個 Day 21 做的黃金範例,依照新格式回頭寫出它的規格。 如果格式的表達力夠,這件事應該很順。如果卡住了,代表格式有問題。
而這一步還有一個附帶好處:你會得到第一份規格,而且它對應的實作已經存在、已經是完美的。這份規格可以直接當成規格的範例。薪資工廠那 43 次紀錄的前兩筆就是這個:
labor-insurance(黃金範例反向工程)    工廠建置時人工打造,非 skill 產出
health-insurance(黃金範例反向工程)  同上
它們被誠實地標成「非 skill 產出」,不計入一次通過率。
這種記帳紀律,是那個 36/37 有意義的原因。
notes 後門,但也不要動不動改 schema——判準是「值不值得動地基」明天講一個很小、但我認為是整套工廠最聰明的設計:怎麼防止「有程式沒規格」的漂移。


 iThome鐵人賽
 看影片追技術